精选科研项目
本团队与合作者开源的研究系统,涵盖具身智能与机器人操作、自动驾驶、生成模型以及高效多模态基础模型等方向。
# 共同一作* 通讯作者
-
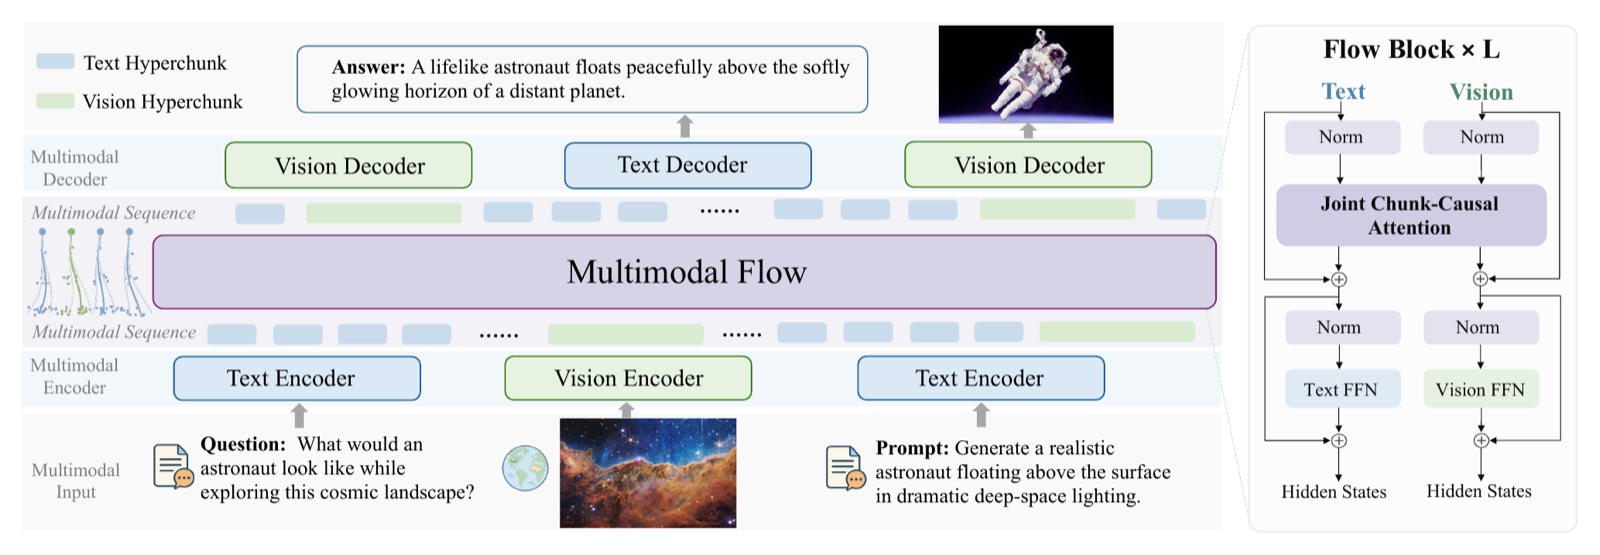
Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces
全连续多模态流式框架:将各模态编码为连续 hyperchunk 并置于统一的 chunk 因果序列中,以同一接口统一理解、生成与灵活的混合序列建模。
-
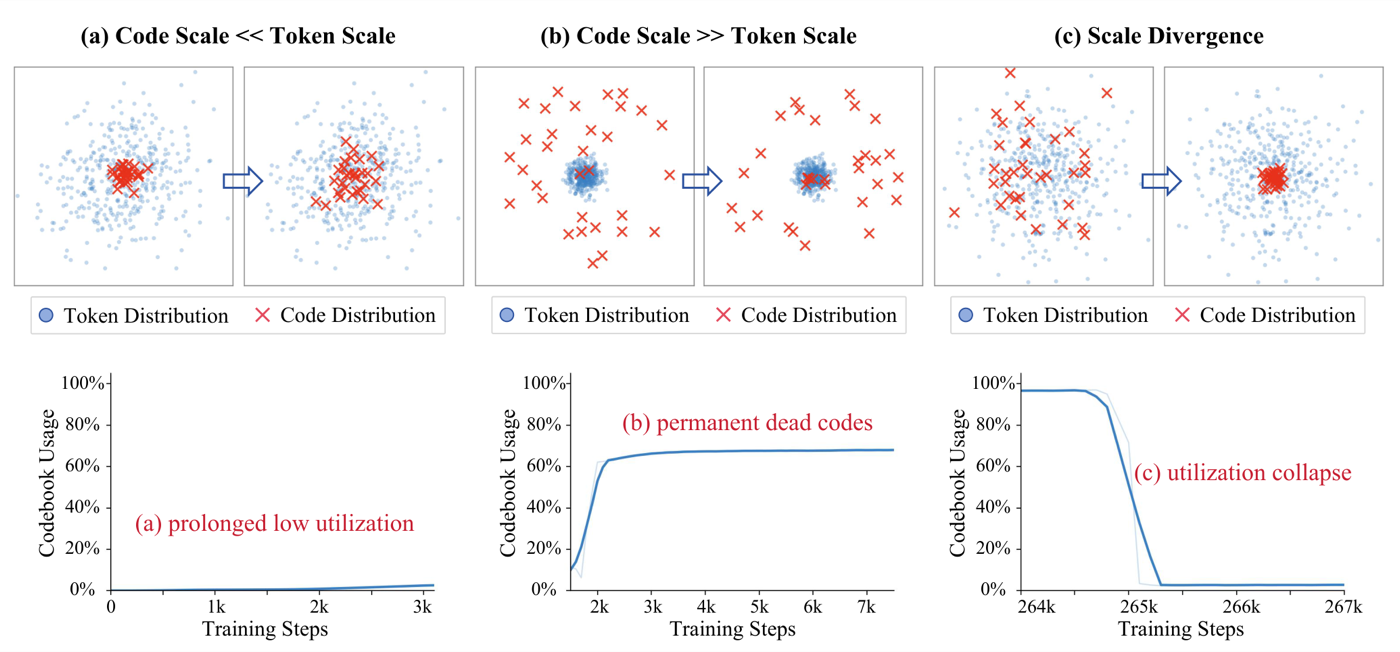
StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training
关注点分离框架——Dynamic STE 稳定重构梯度、Region VQ Loss 显式追踪分布、解耦学习率调度——让稳定的 VQ tokenizer 训练成为有原则可循的性质,零新增参数实现 100% codebook 利用率。
-
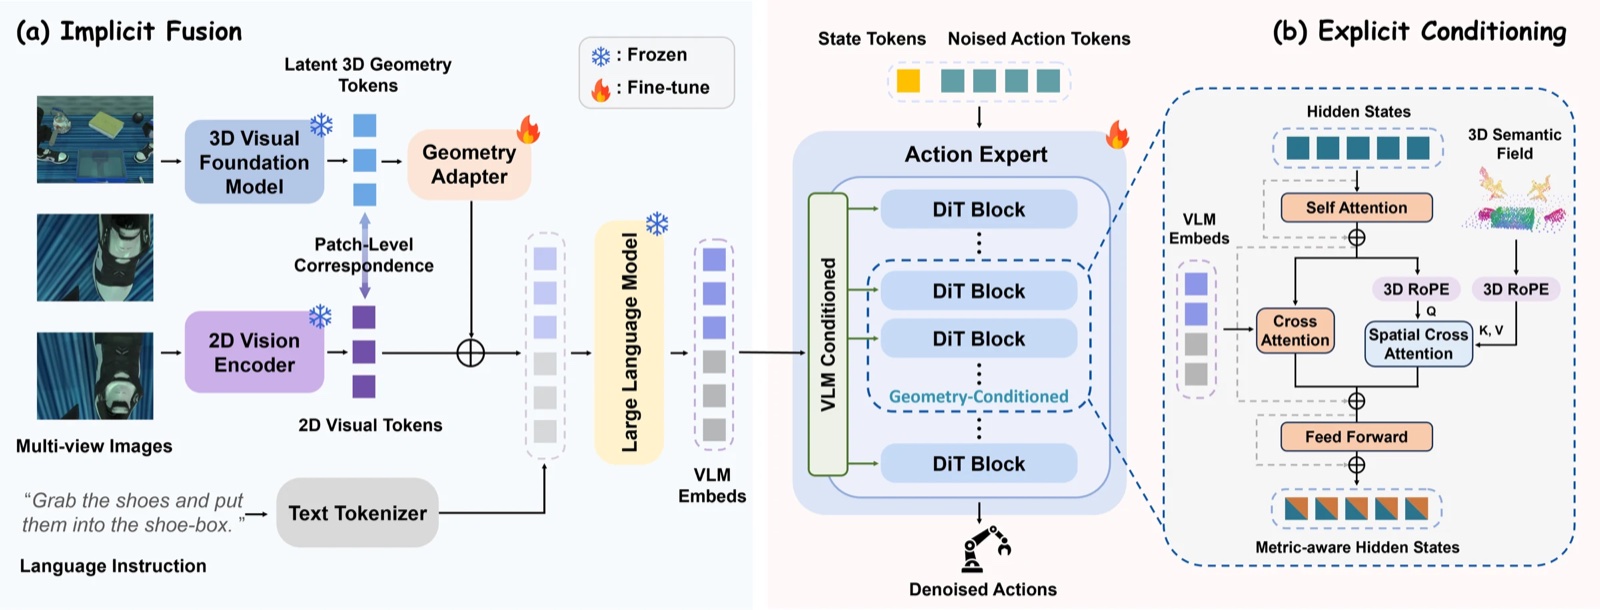
Bridge3D: Enabling Vision-Language-Action Models to See and Act in 3D
将隐式与显式 3D 几何引导注入预训练 2D VLA 模型:VGGT 几何特征融合增强 3D 感知,3D 语义点场显式指导动作去噪;RoboTwin 2.0 平均成功率 84.8%,真机较 Spatial Forcing 提升 11.7 个百分点。
-
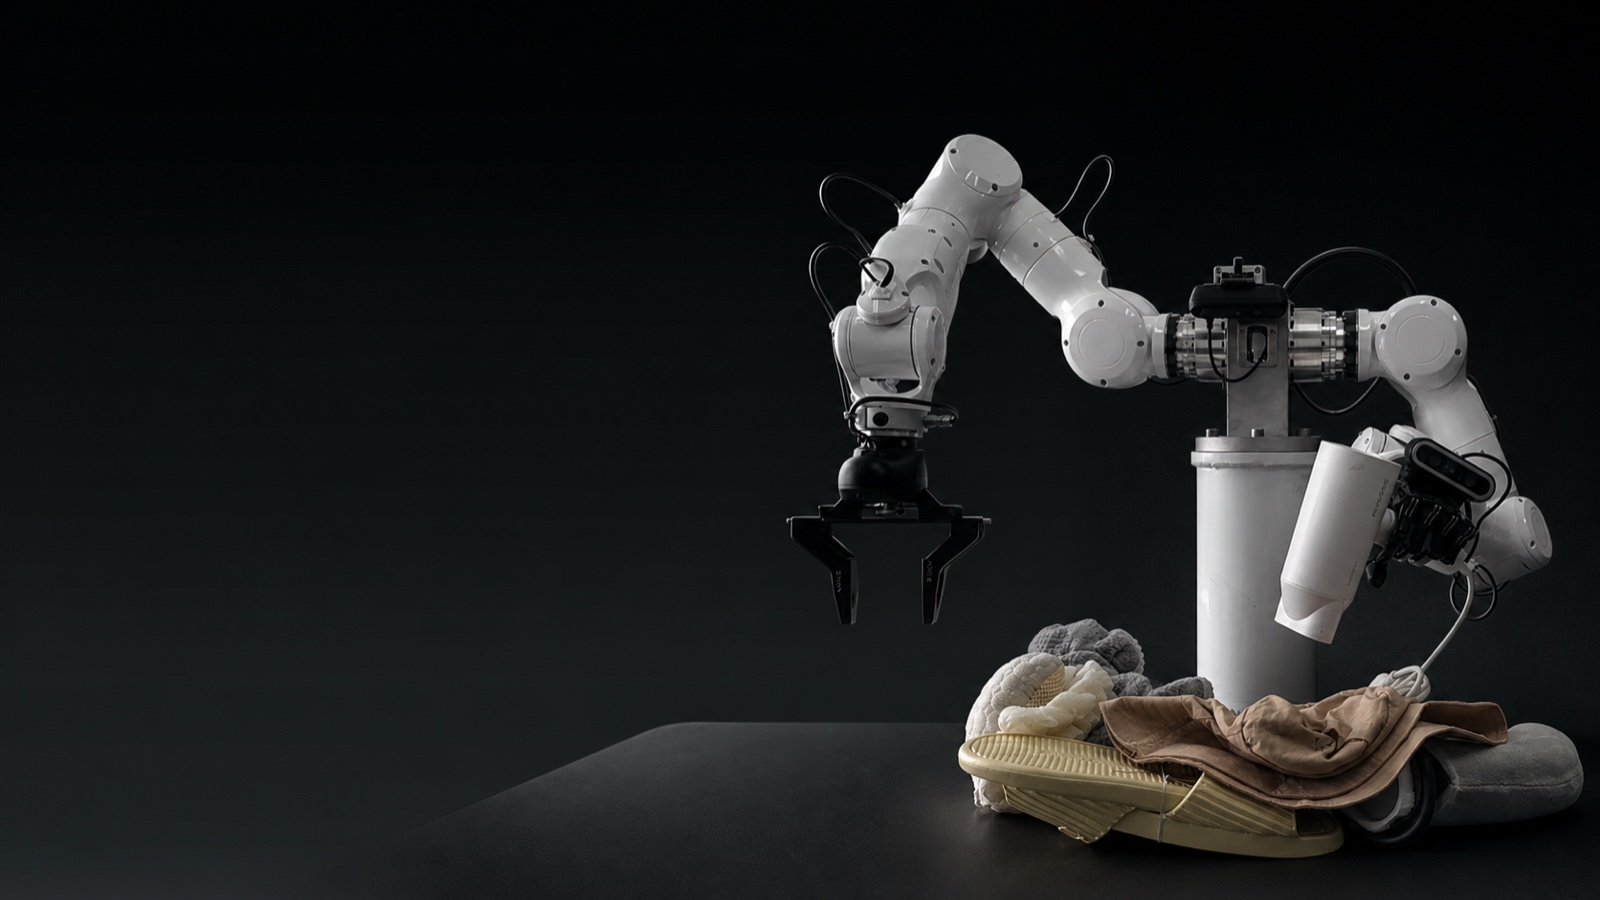
AdaRoboVLG: Adaptive Vision-Language Grasping via Composable Foundation Priors and Generalizable Grasp Synthesis
任务自适应的视觉-语言-抓取框架,将物理抓取合成与任务理解解耦,通过可组合的基础模型先验实现跨不同机械手的泛化抓取。
-
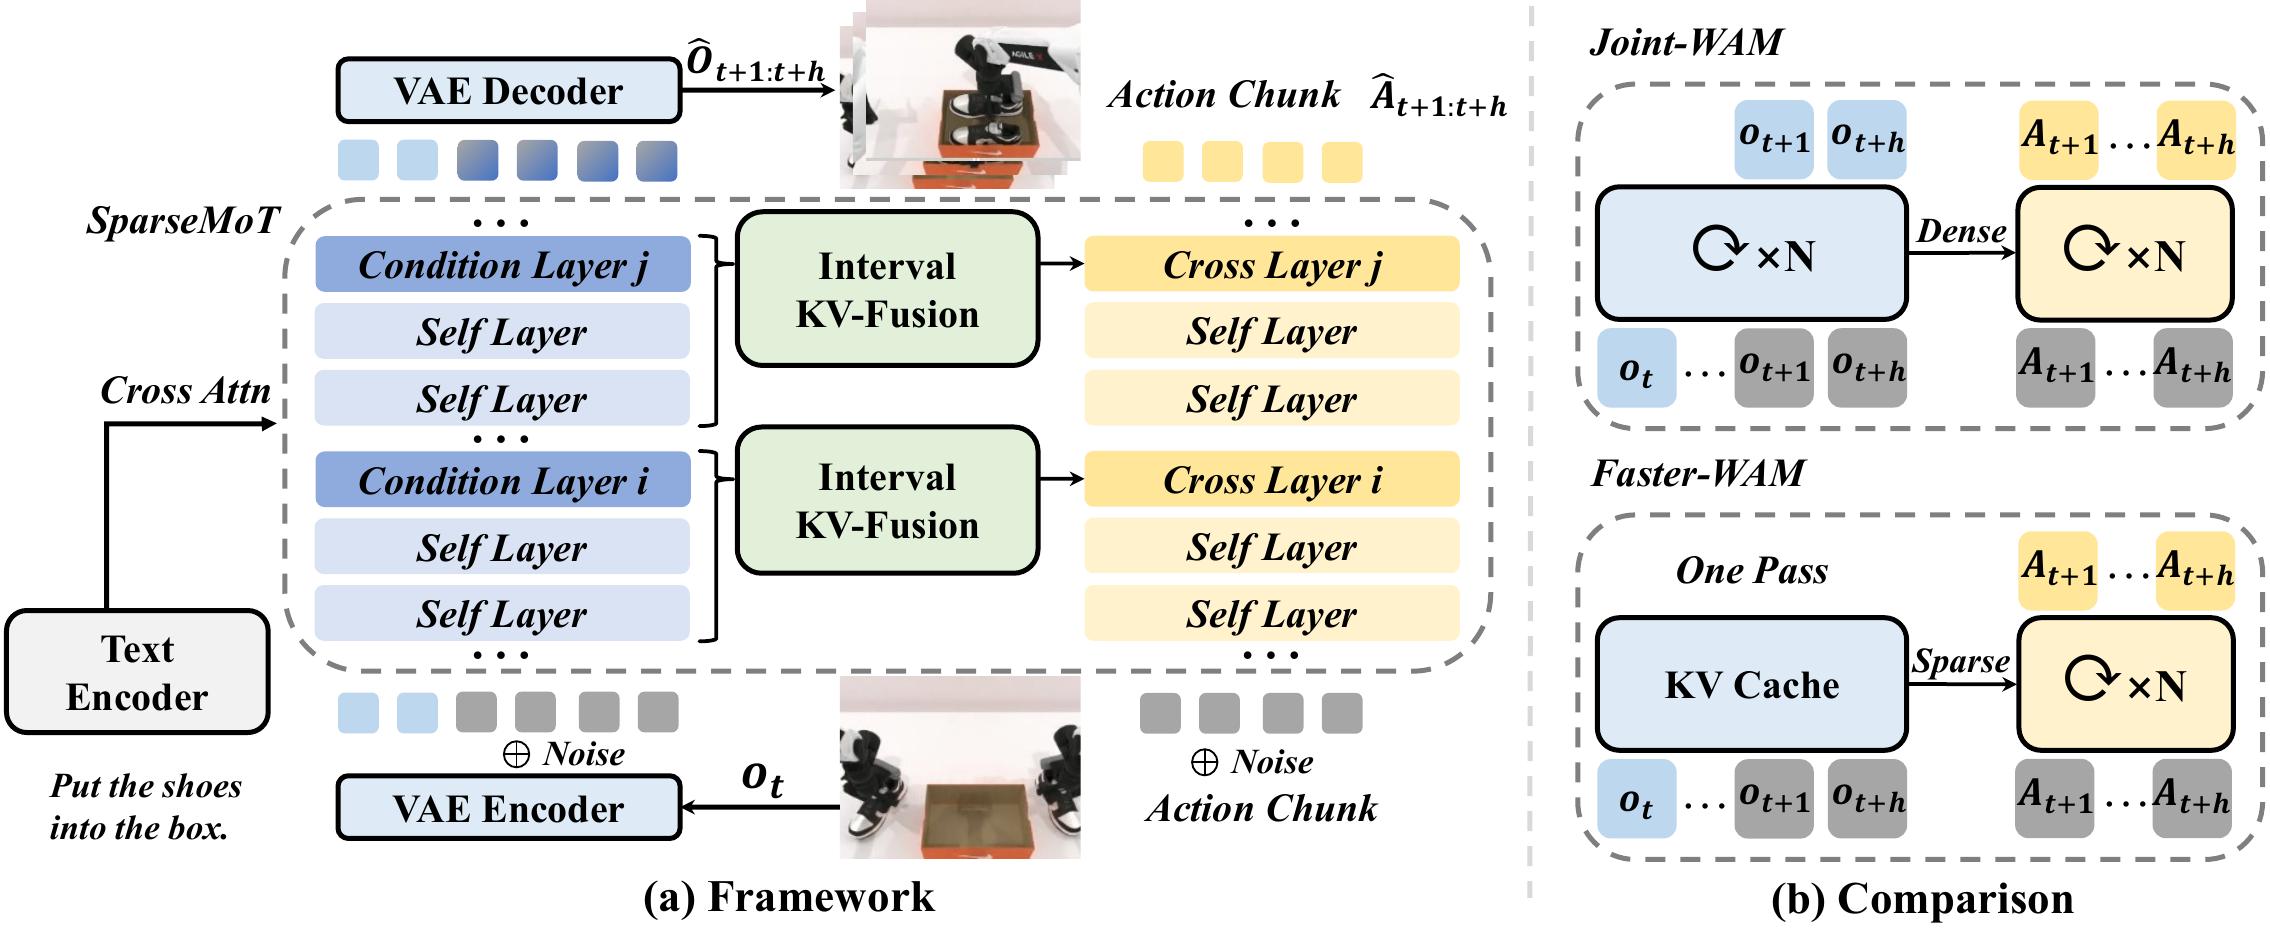
DreamWAM: Beyond RGB Future Prediction for World Action Models
超越 RGB 的世界动作模型:将未来预测重构为结构化世界建模,从外观、运动、几何、语义四个互补视角表征未来状态,实现稳健的机器人操作。
-
-
-
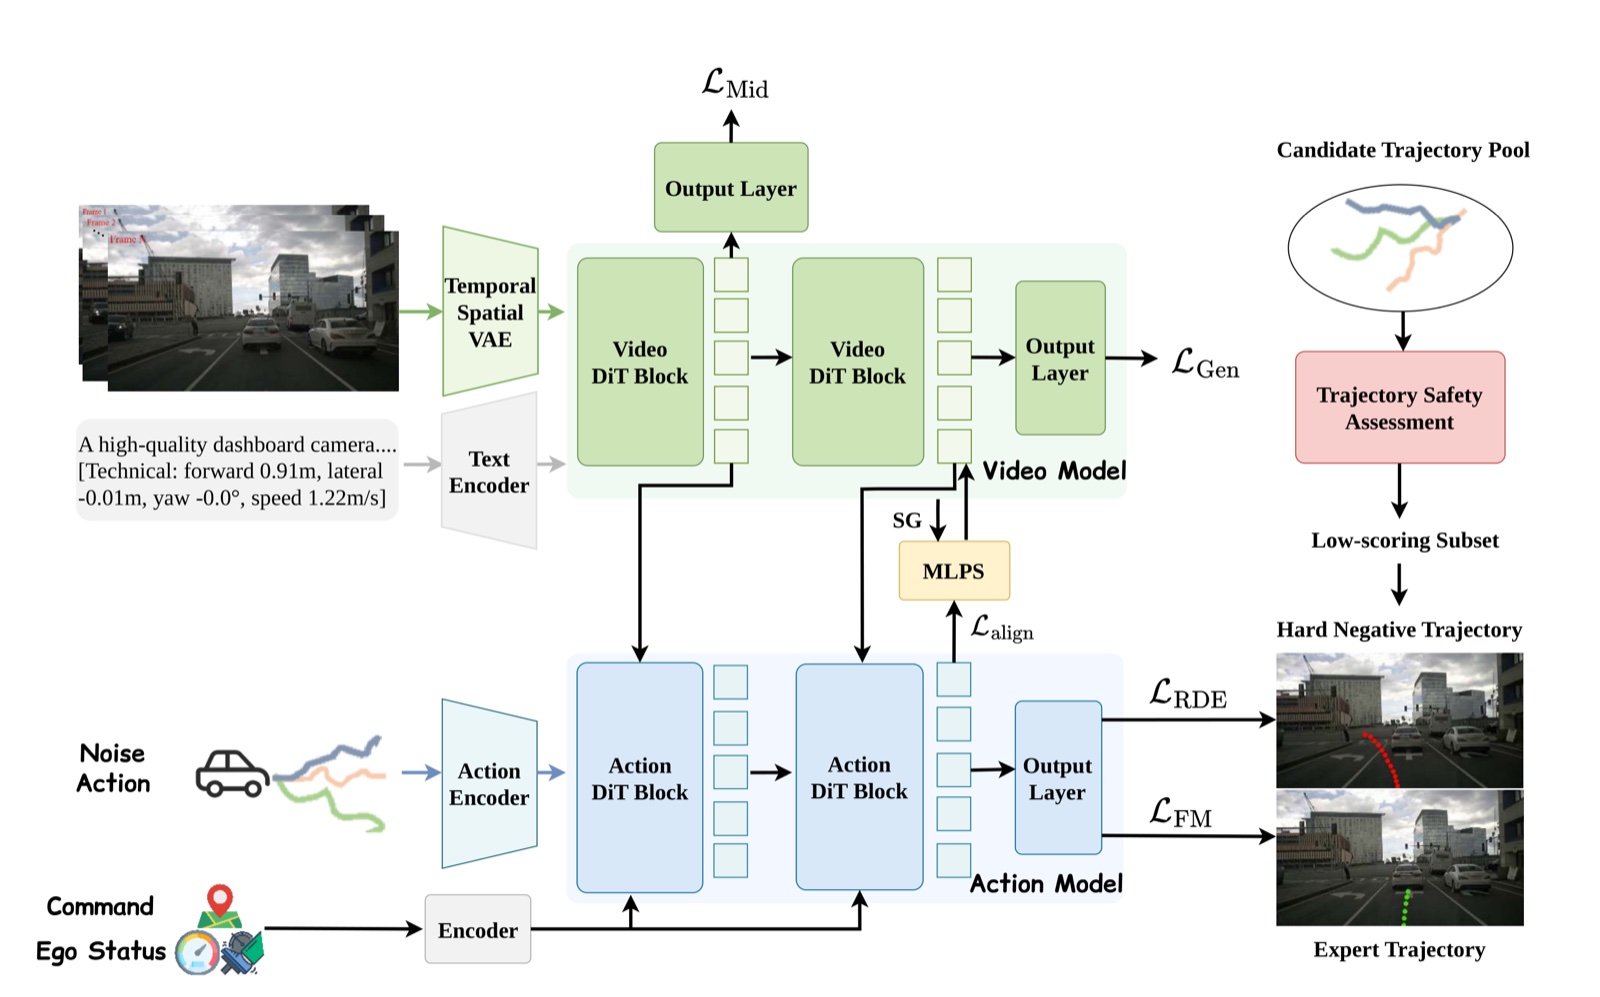
ReWorld: Learning Better Representations for World Action Models
首个面向自动驾驶世界动作模型的表示学习框架,无需外部编码器与教师模型,仅增加 0.3% 训练开销,显式优化从世界到动作的隐表征通路。
-
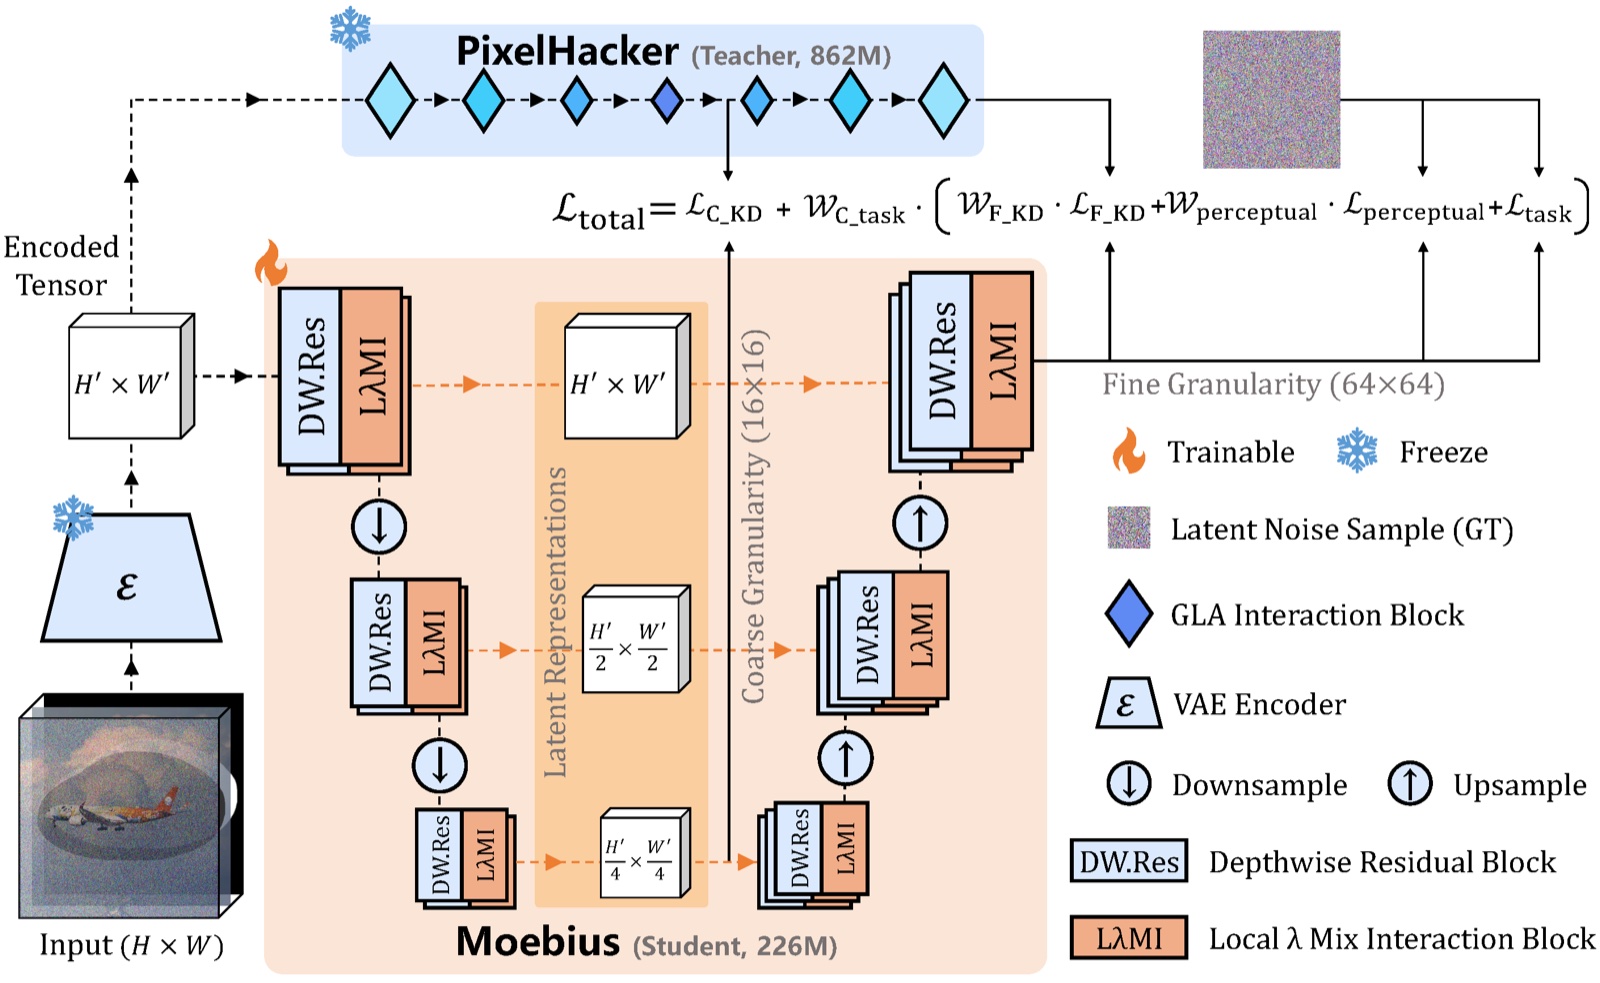
Moebius: 0.2B Lightweight Image Inpainting Framework with 10B-Level Performance
0.2B 轻量级图像修复框架,性能达到 10B 级别模型水平。
-
MotionVLA: Injecting Geometric Motion into Vision-Language-Action Model
将严格过去帧的几何运动压缩为紧凑、可查询的轨迹场 token 注入 VLA,为策略提供时间连续的运动历史,提升长时程操作能力。
-
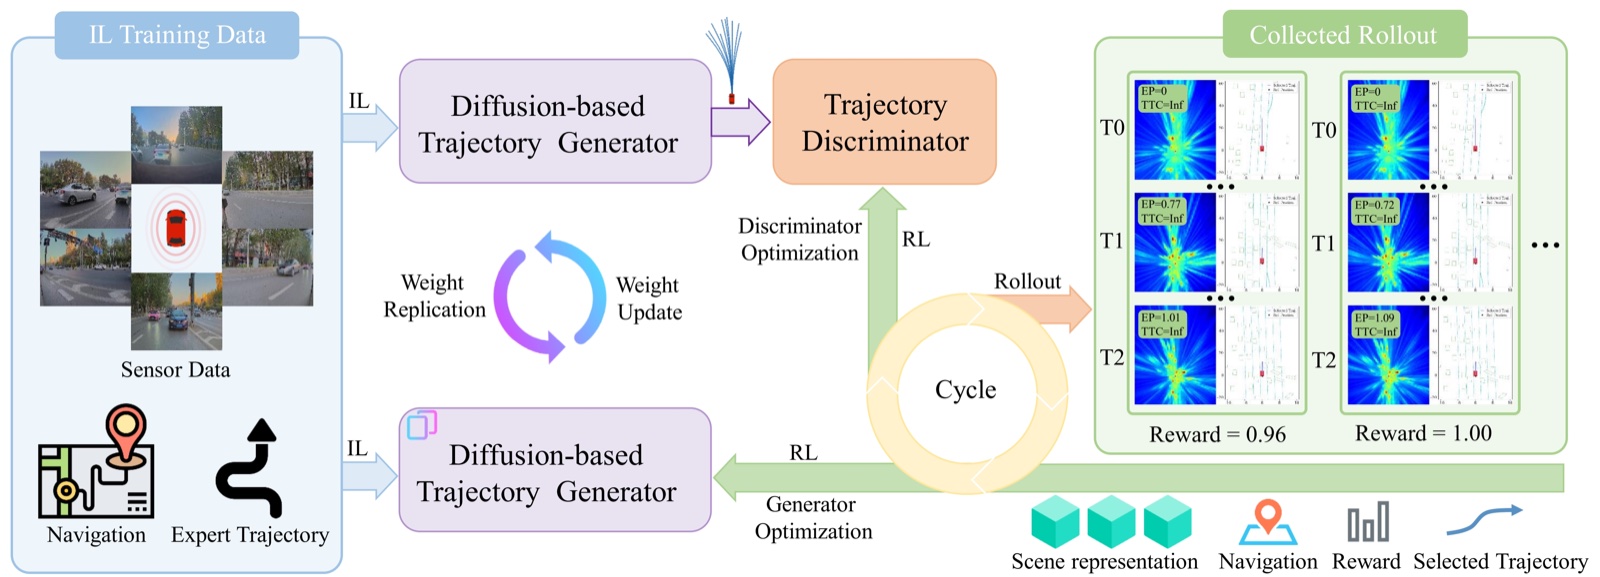
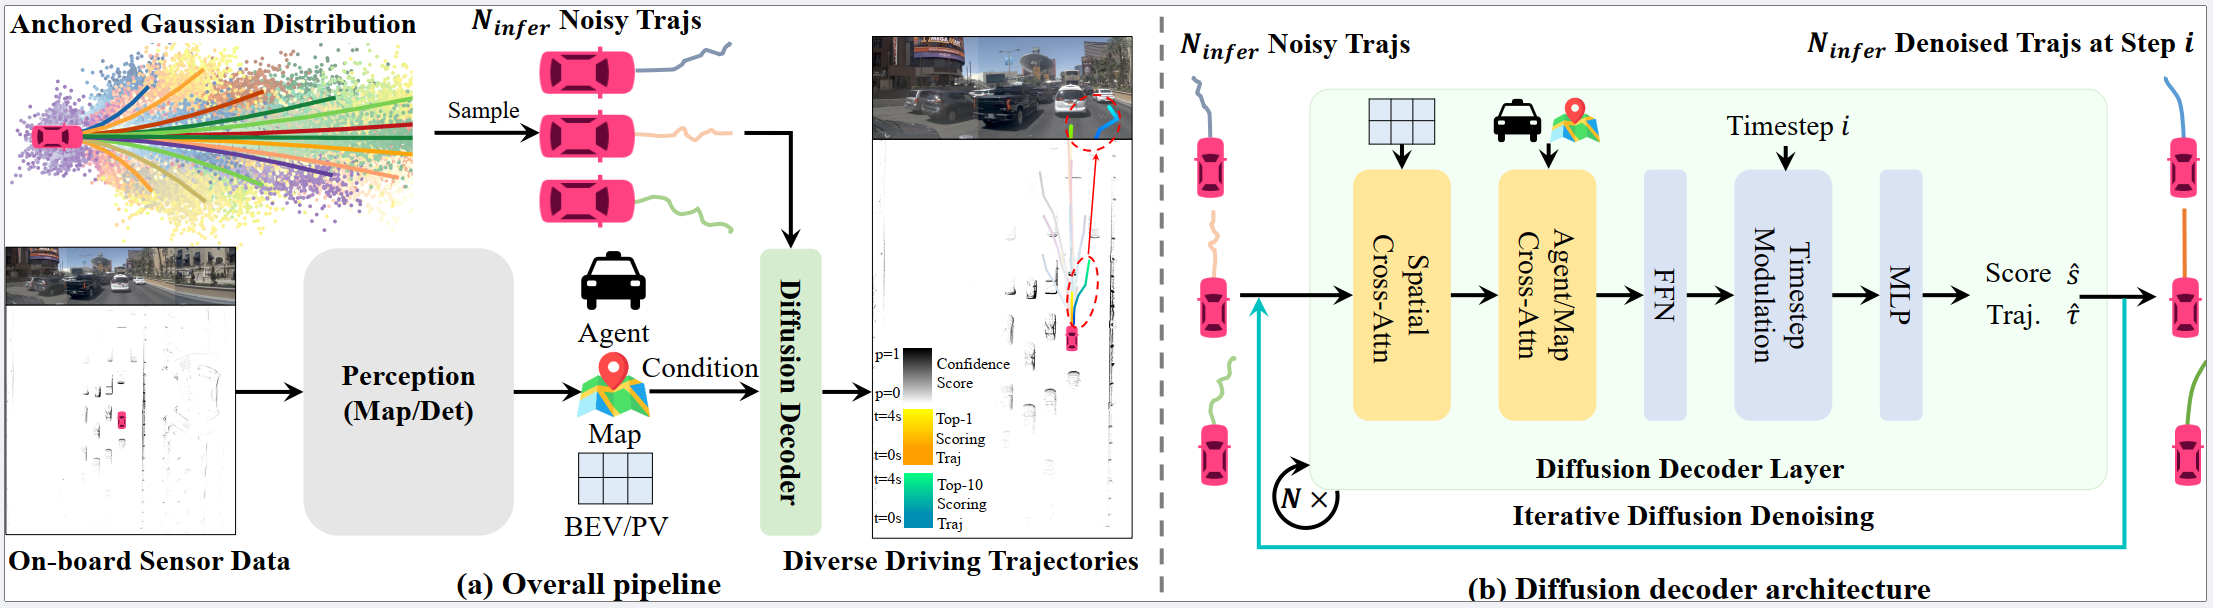
RAD-2: Scaling Reinforcement Learning in a Generator-Discriminator Framework
闭环驾驶的生成器-判别器框架:扩散生成器产生多样化候选轨迹,强化学习优化的判别器按长期驾驶质量重排序,碰撞率较主流扩散规划器降低 56%。
-
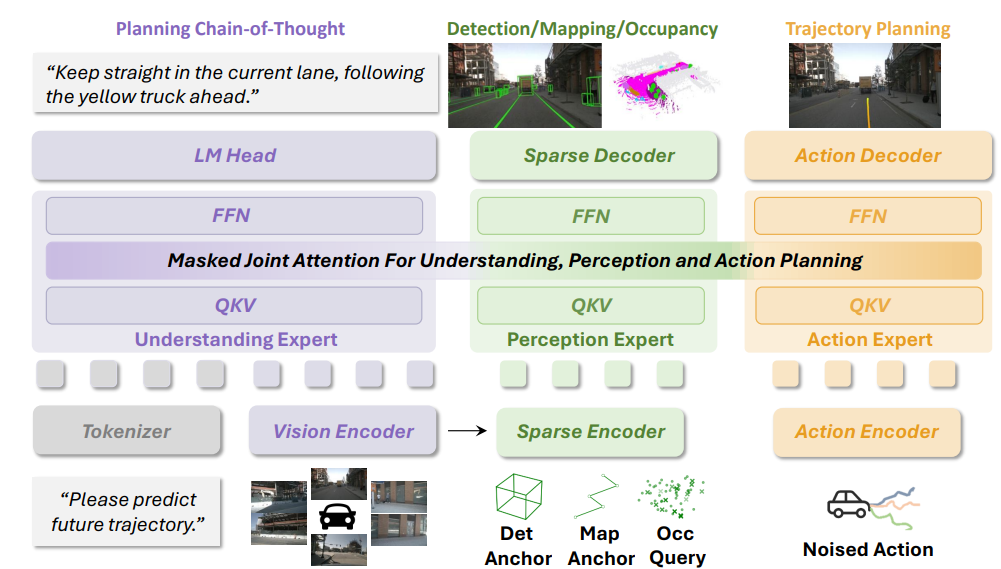
UniDriveVLA: Unifying Understanding, Perception, and Action Planning for Autonomous Driving
基于 Mixture-of-Transformers 的统一驾驶视觉-语言-动作模型,将驾驶理解、场景感知与动作规划解耦到三个专家网络,通过掩码联合注意力协同工作。
-
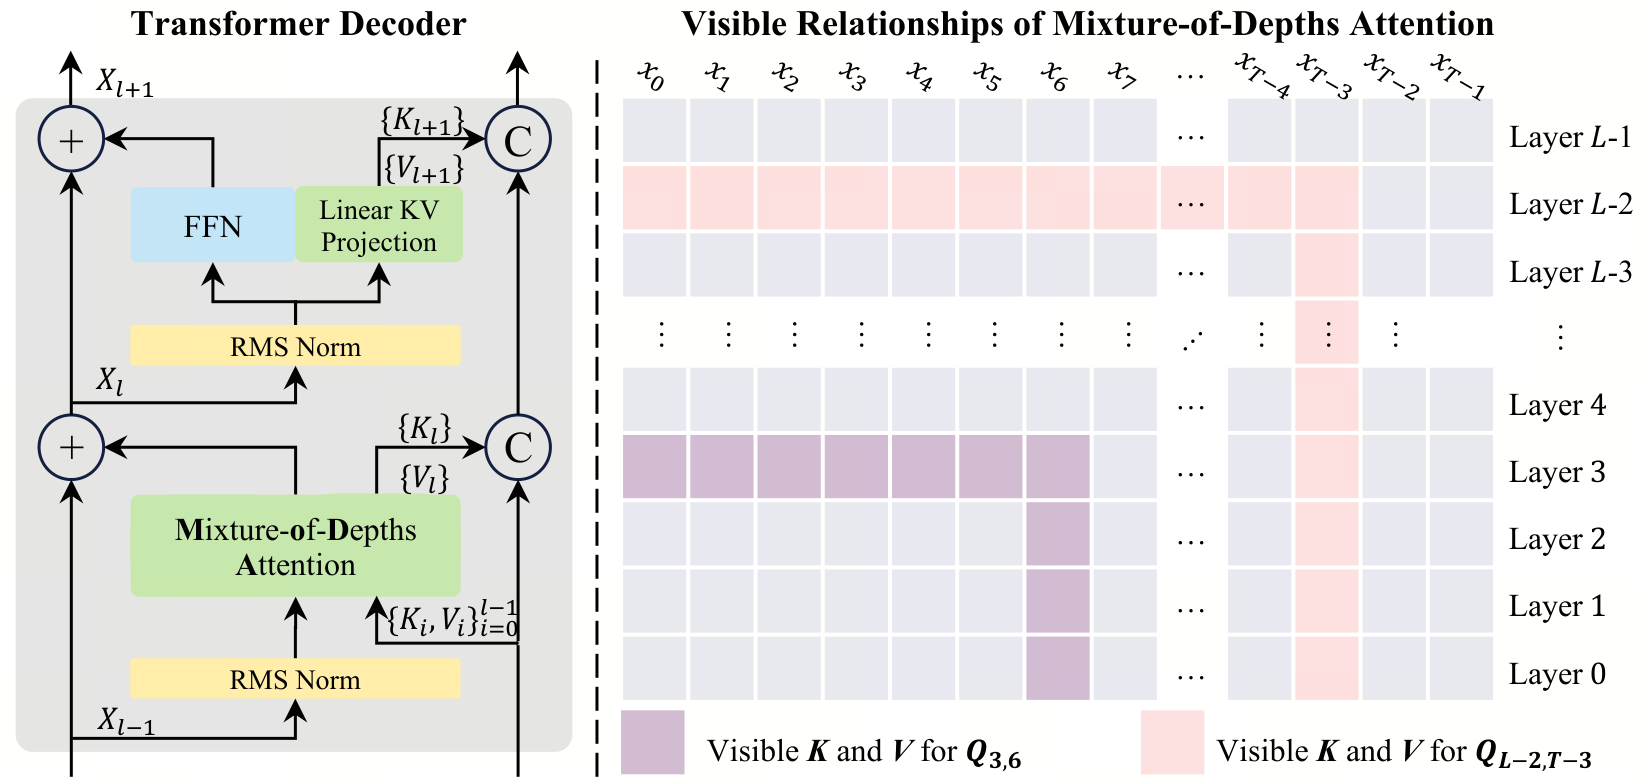
-
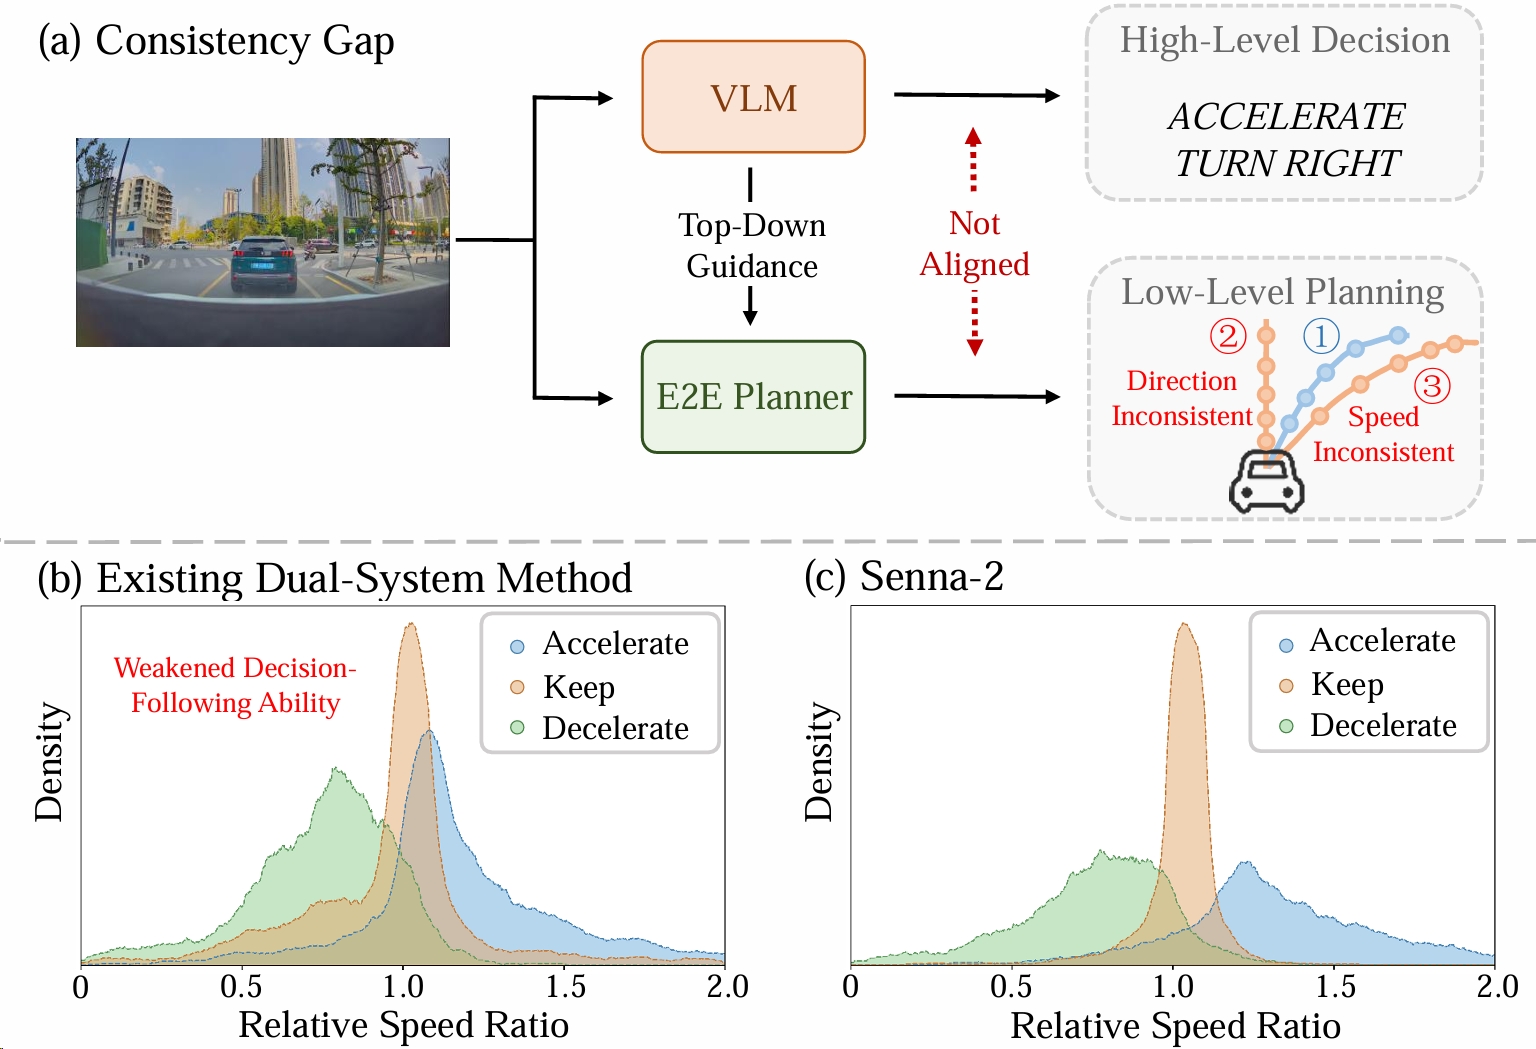
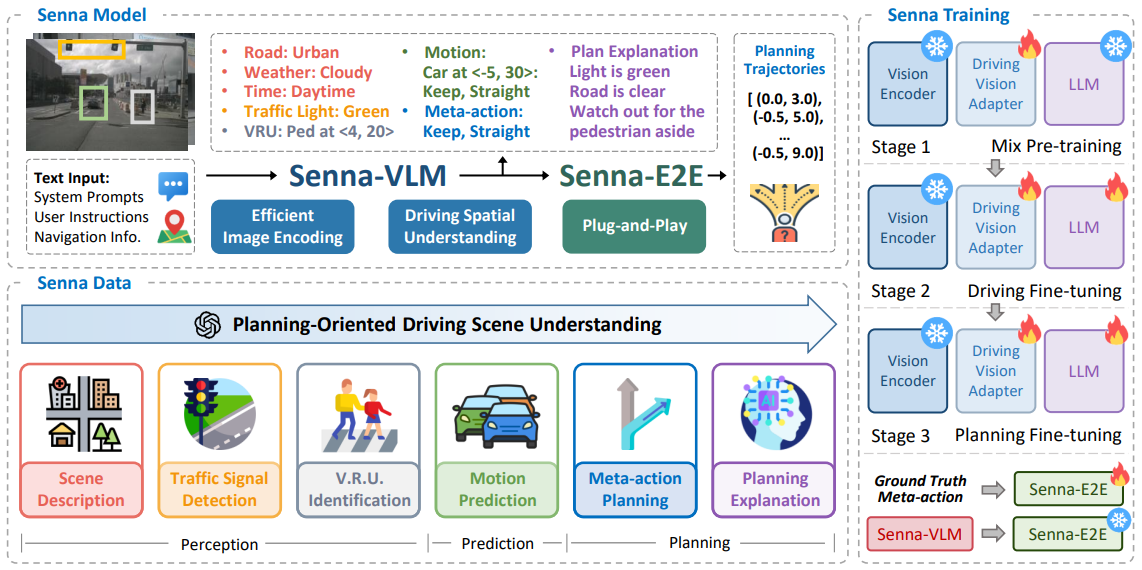
Senna-2: Aligning VLM and End-to-End Driving Policy for Consistent Decision Making and Planning
显式对齐 VLM 高层决策与端到端策略低层规划的驾驶模型,通过面向一致性的三阶段训练与 3DGS 环境中的层次化强化学习,显著提升开环与闭环驾驶安全性。
-
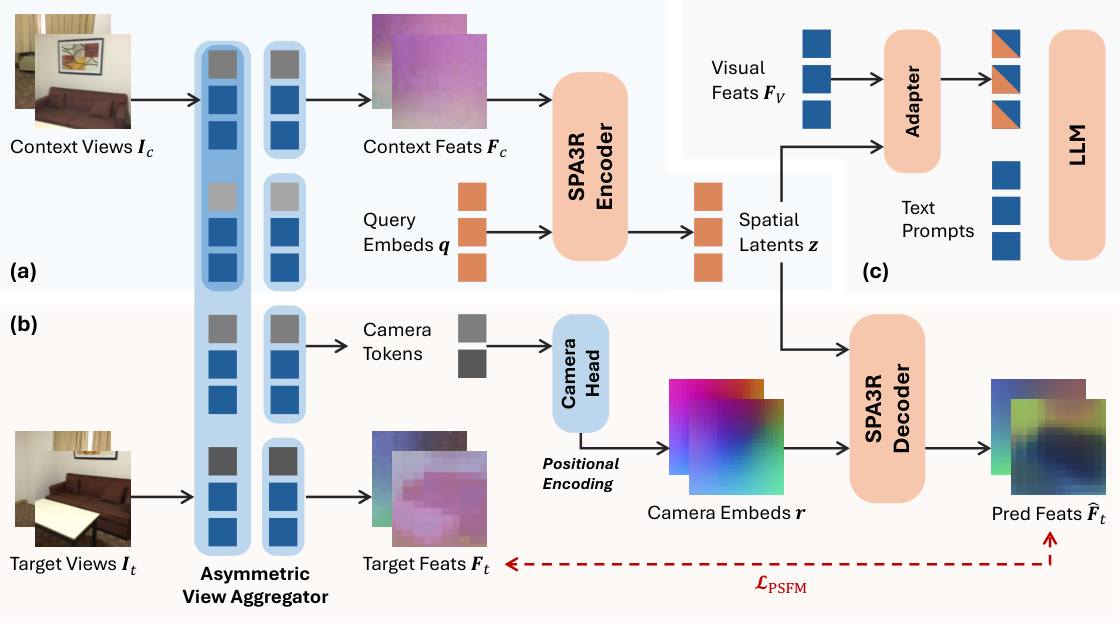
OmniTrack: General Motion Tracking via Physics-Consistent Reference
两阶段人形机器人运动跟踪框架,将物理可行性与通用跟踪解耦:特权通用策略先生成严格满足机器人动力学的参考运动,控制策略再学习跟踪这些可行运动——真机实现长达一小时的稳定跟踪,包括空翻、侧手翻等复杂杂技动作。
-
-
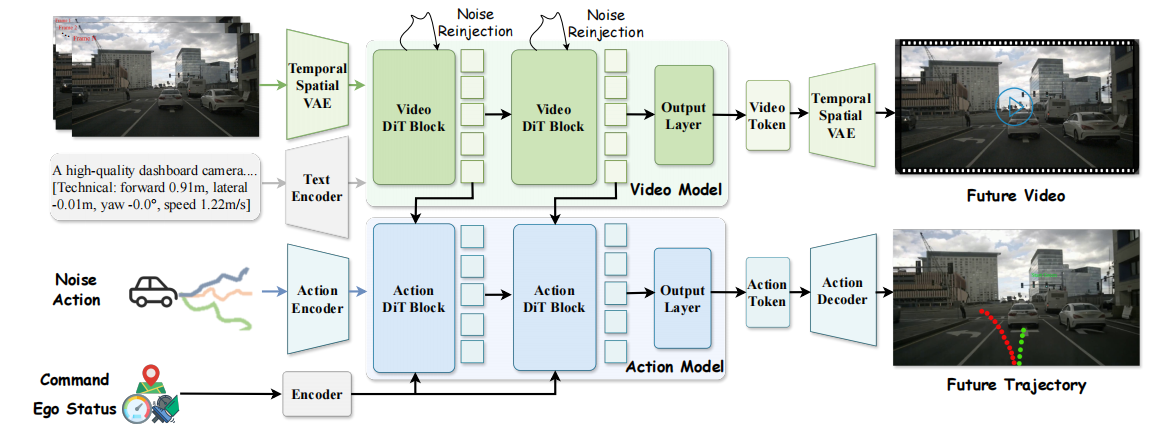
DriveLaW: Unifying Planning and Video Generation in a Latent Driving World
统一视频生成与运动规划的驾驶世界模型:将视频生成器的隐表征直接注入扩散规划器,在 nuScenes 视频预测与 NAVSIM 规划上均达到最先进水平。
-
-
-
-
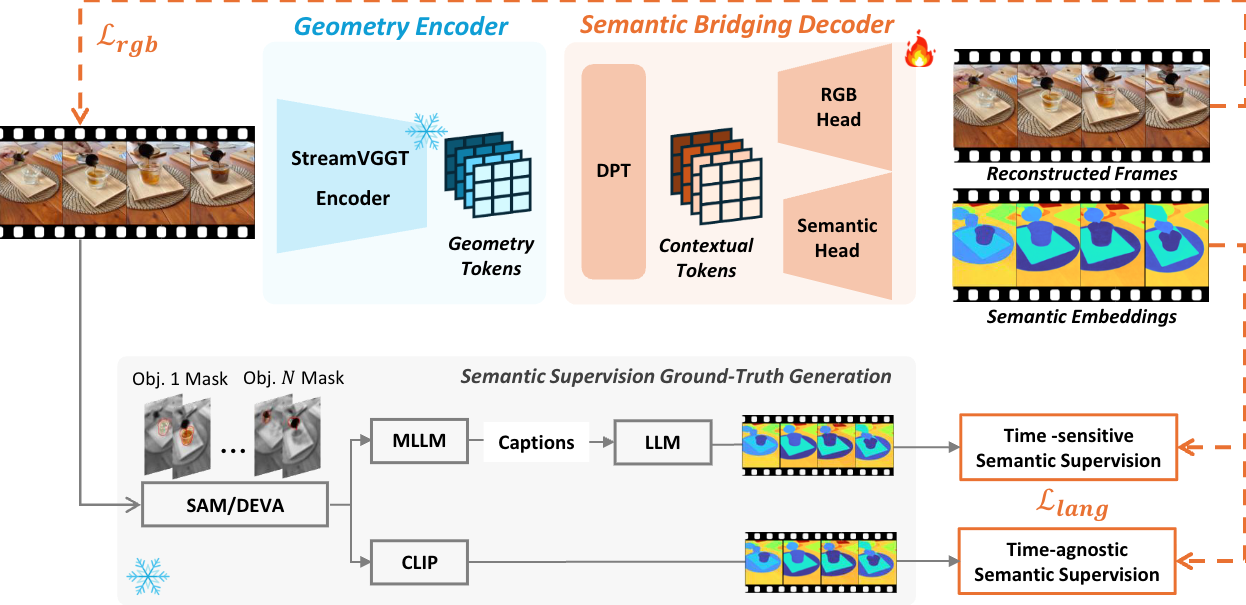
4DLangVGGT: 4D Language-Visual Geometry Grounded Transformer
首个基于 Transformer 的前馈式四维语言接地框架,在单一架构中联合几何感知(StreamVGGT)与语言对齐(语义桥接解码器),无需逐场景优化即可泛化到动态场景。
-
-
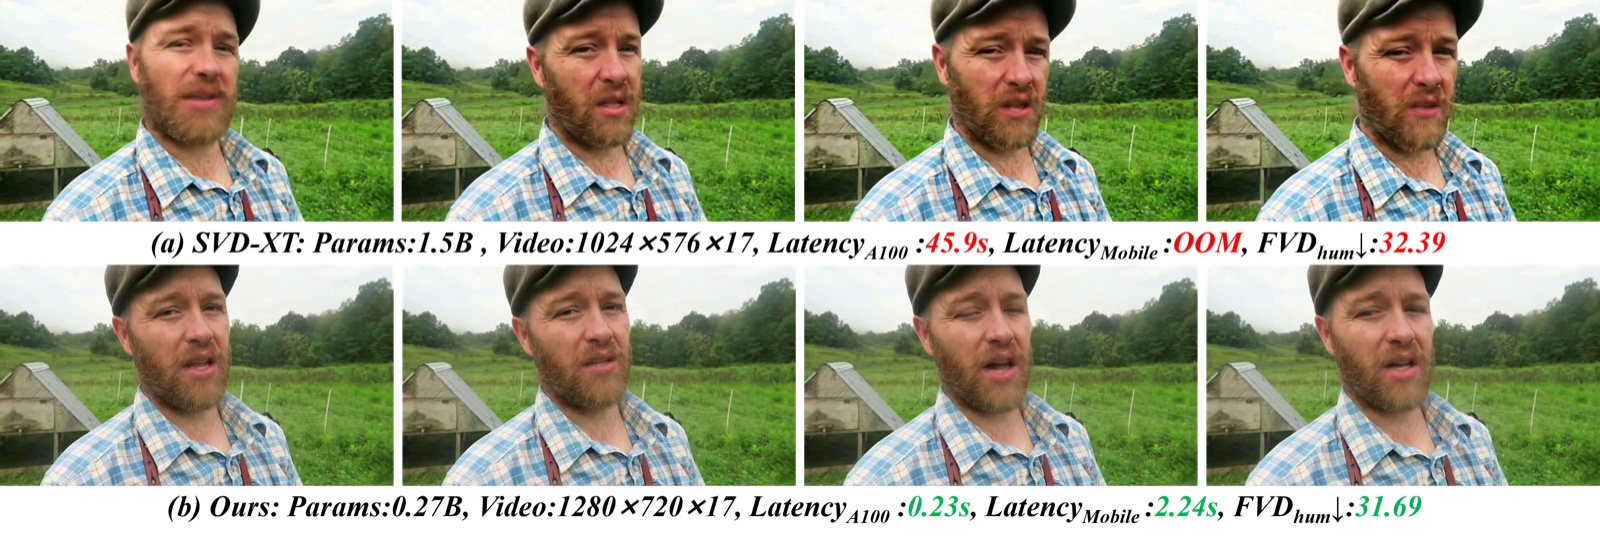
-
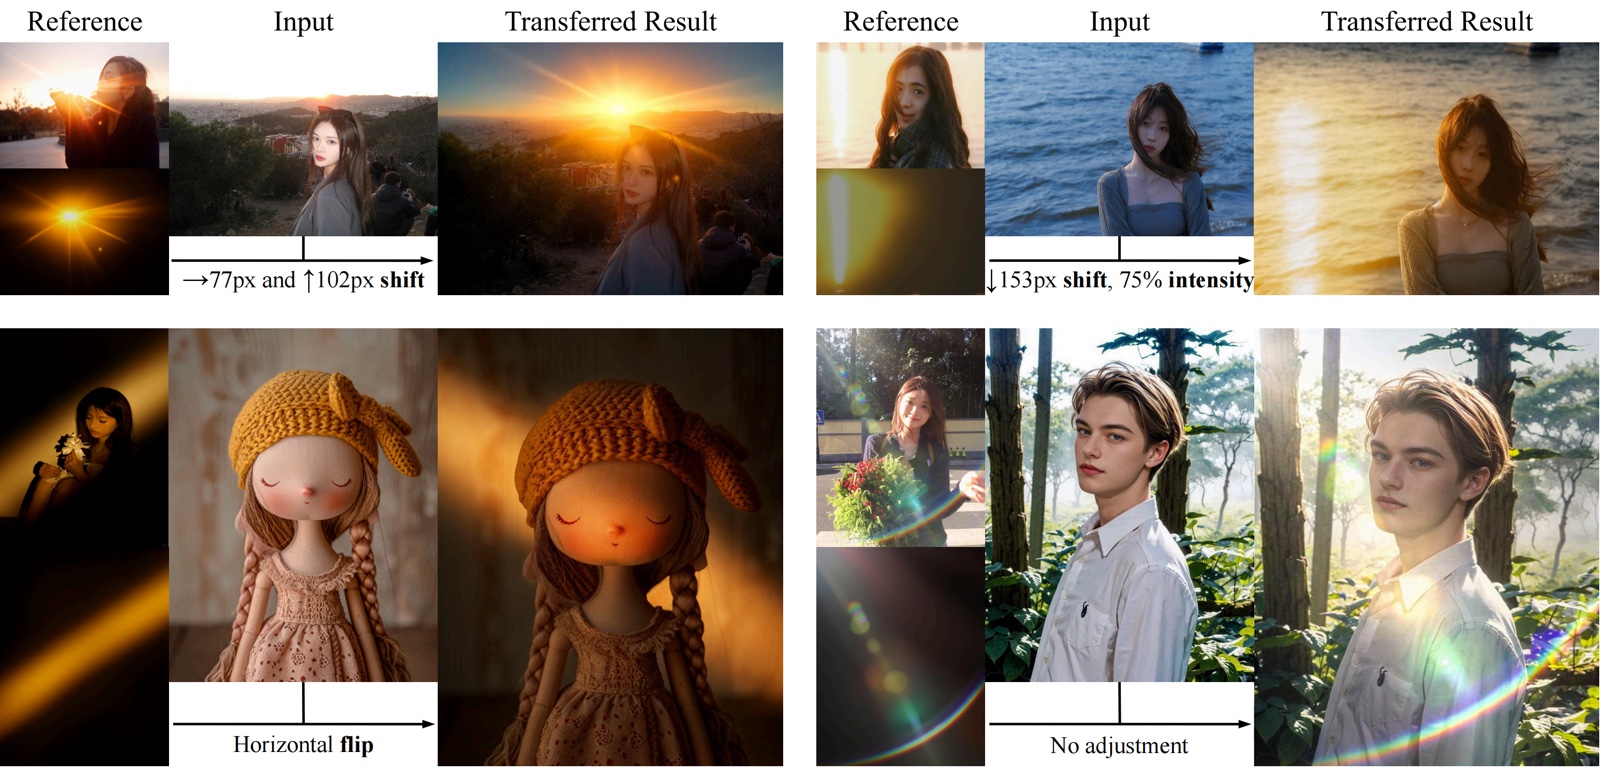
TransLight: Image-Guided Customized Lighting Control with Generative Decoupling
图像引导的定制化光照控制:通过生成式解耦将任意参考图像的光照效果迁移到用户内容上,实现无需文本描述的精确重光照。
-
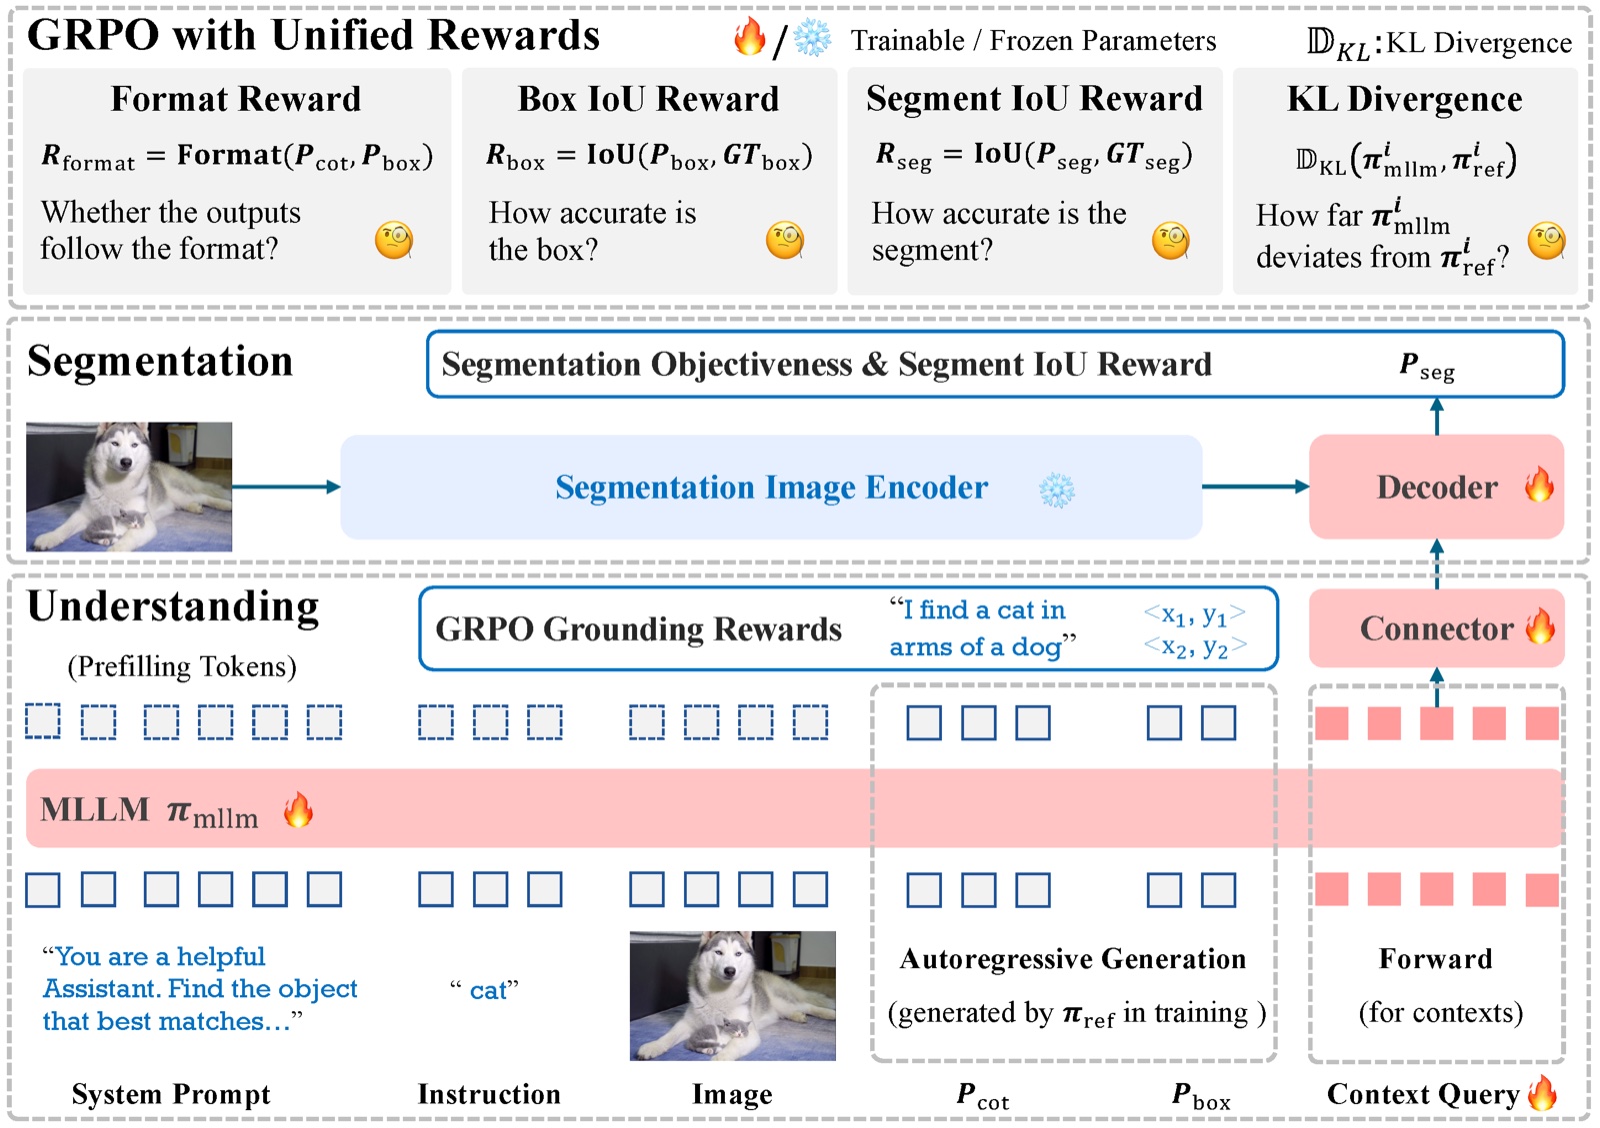
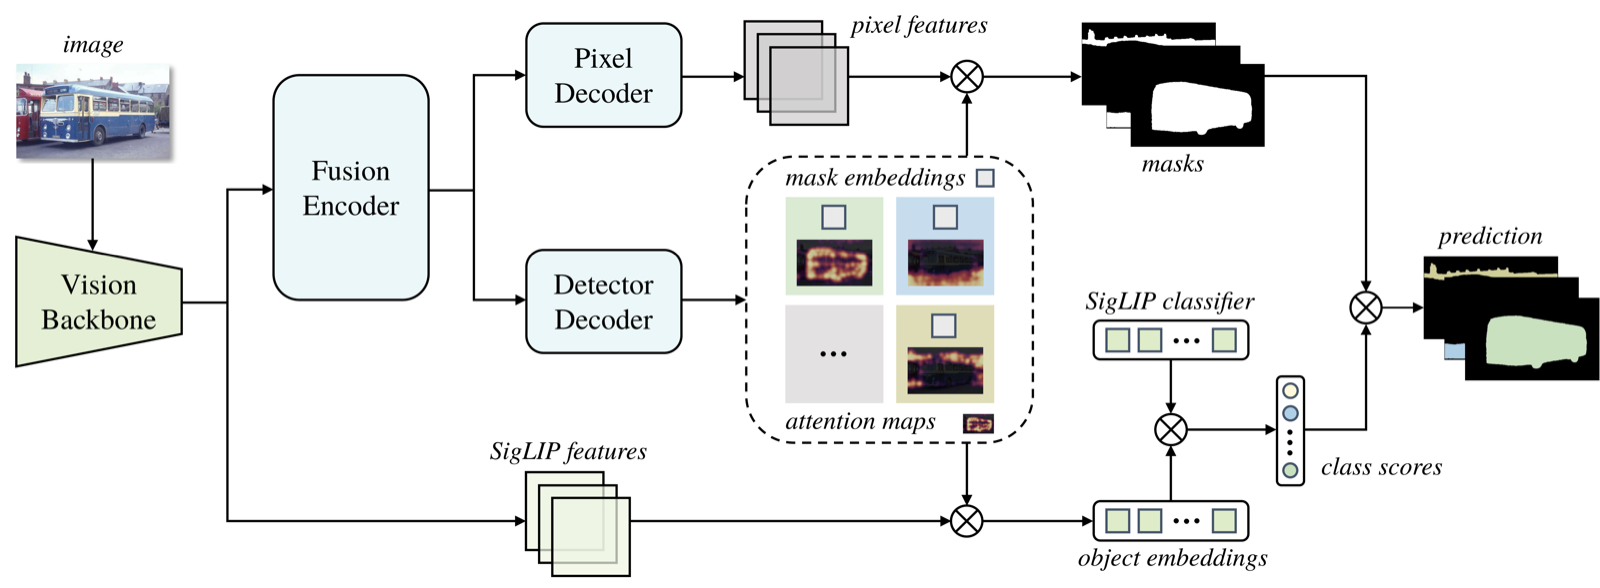
LENS: Learning to Segment Anything with Unified Reinforced Reasoning
统一强化推理的万物分割:多模态模型对复杂指代表达进行推理并输出精确分割掩码,全流程以强化学习端到端训练。
-
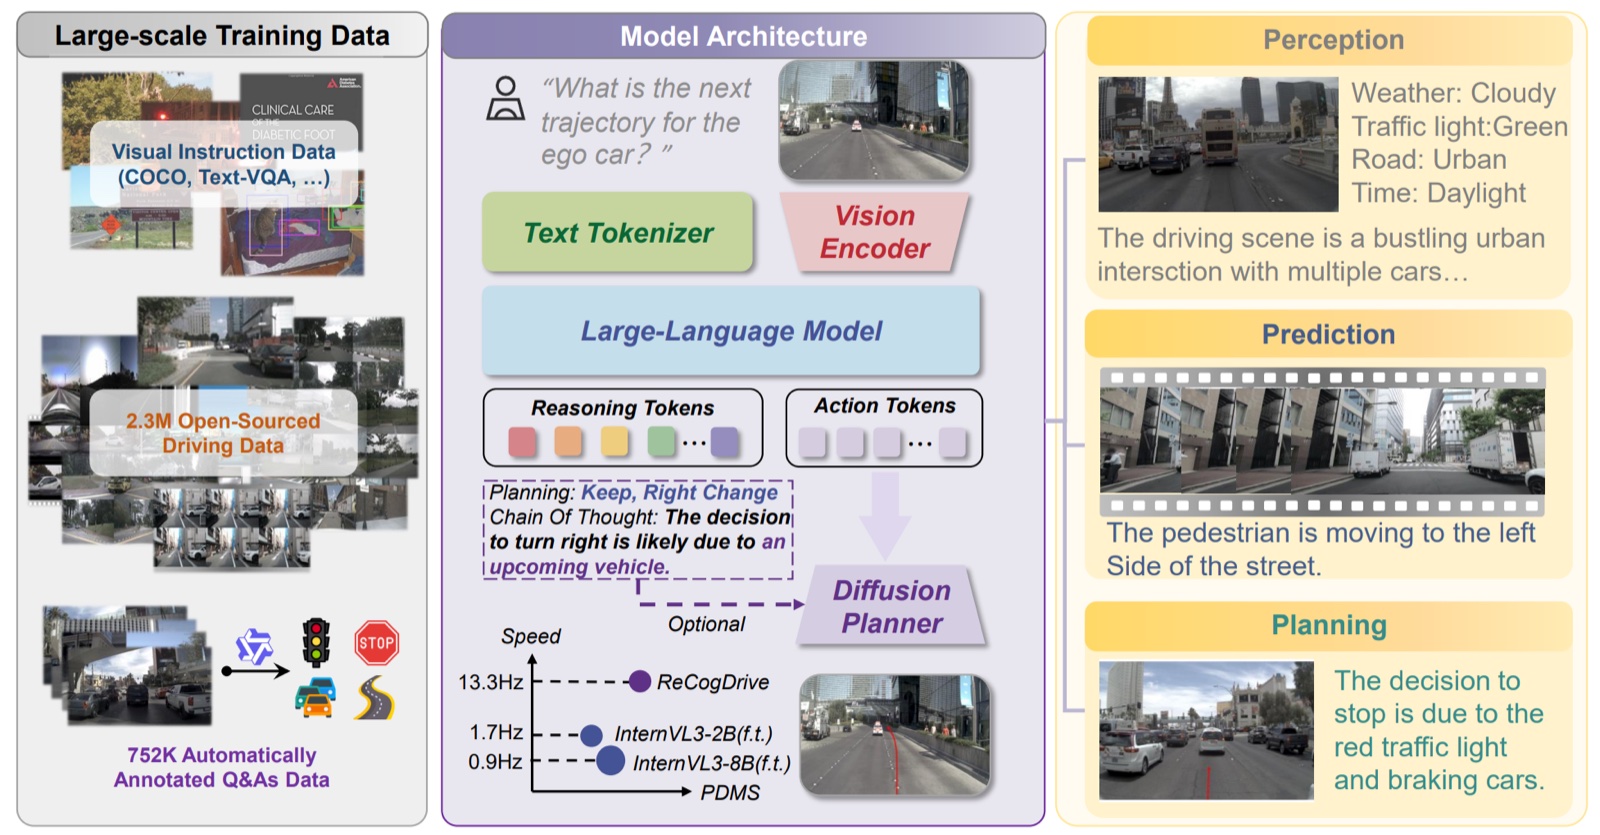
ReCogDrive: A Reinforced Cognitive Framework for End-to-End Autonomous Driving
强化认知驾驶框架:认知增强的视觉语言模型与扩散规划器相结合,并通过 DiffGRPO 强化学习进一步提升轨迹的安全性与舒适性。
-
-
-
-
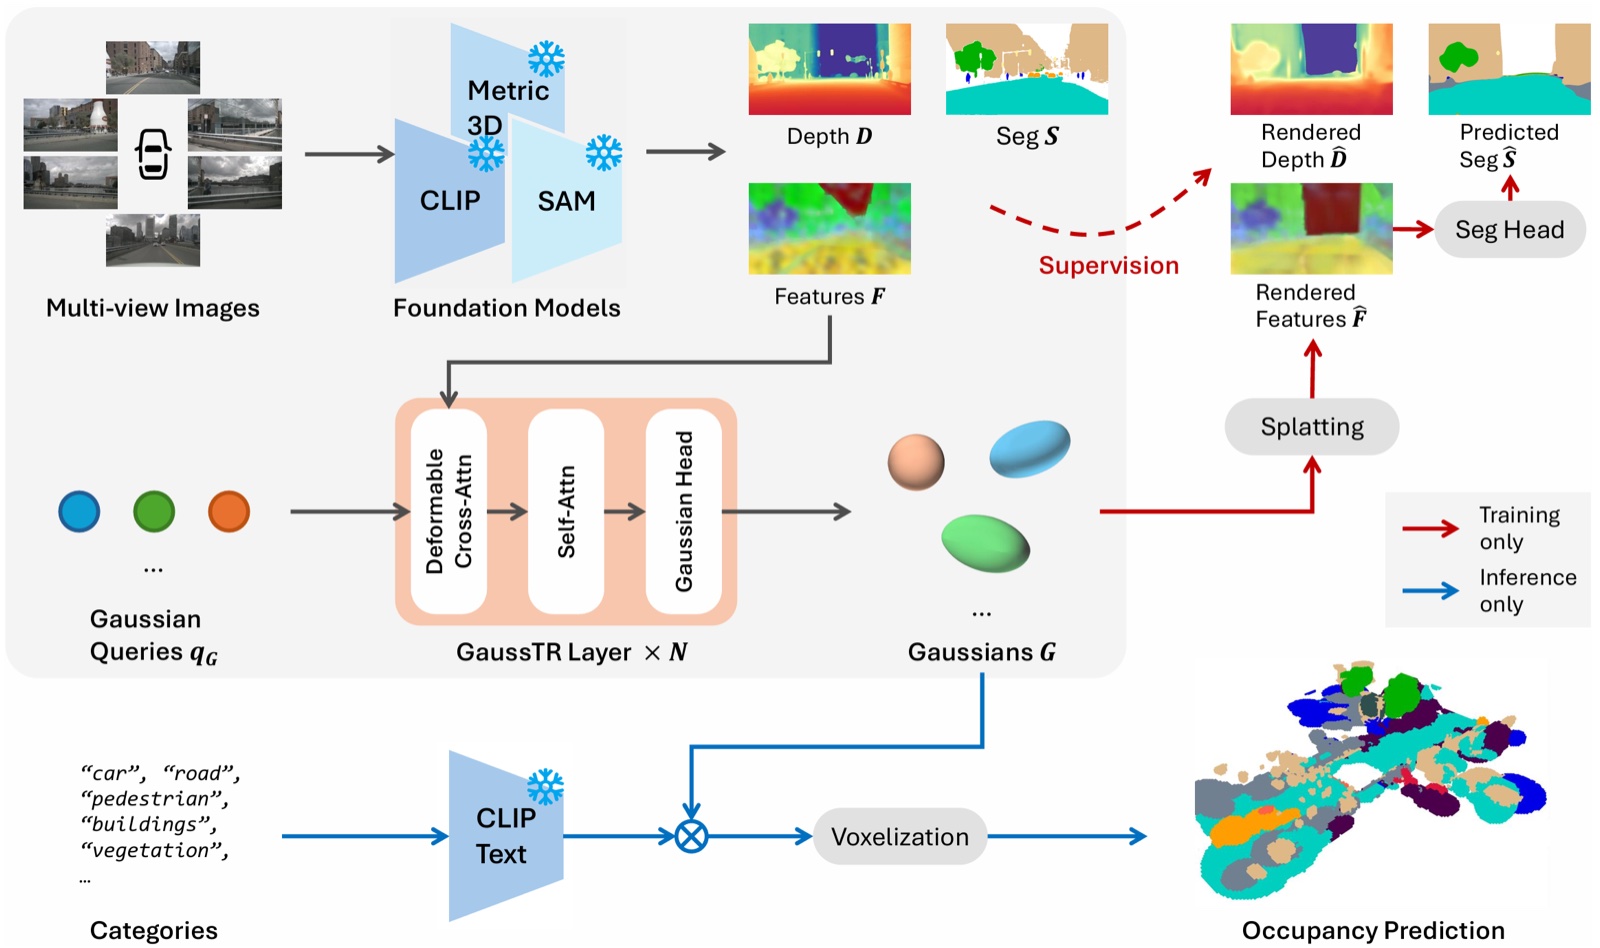
GaussTR: Foundation Model-Aligned Gaussian Transformer for Self-Supervised 3D Spatial Understanding
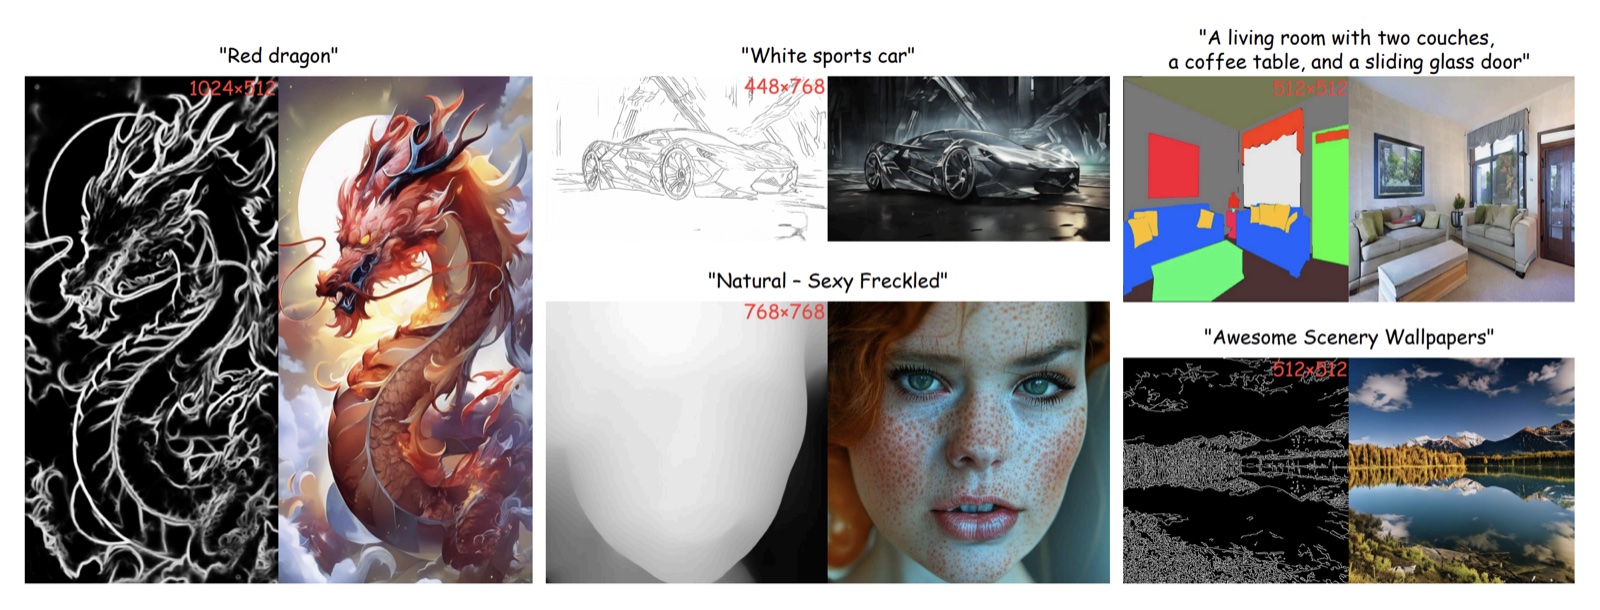
自监督三维空间理解:将基于高斯的三维表征与基础模型特征对齐,无需人工三维标注即可实现开放词汇的三维感知。
-
-
-
-
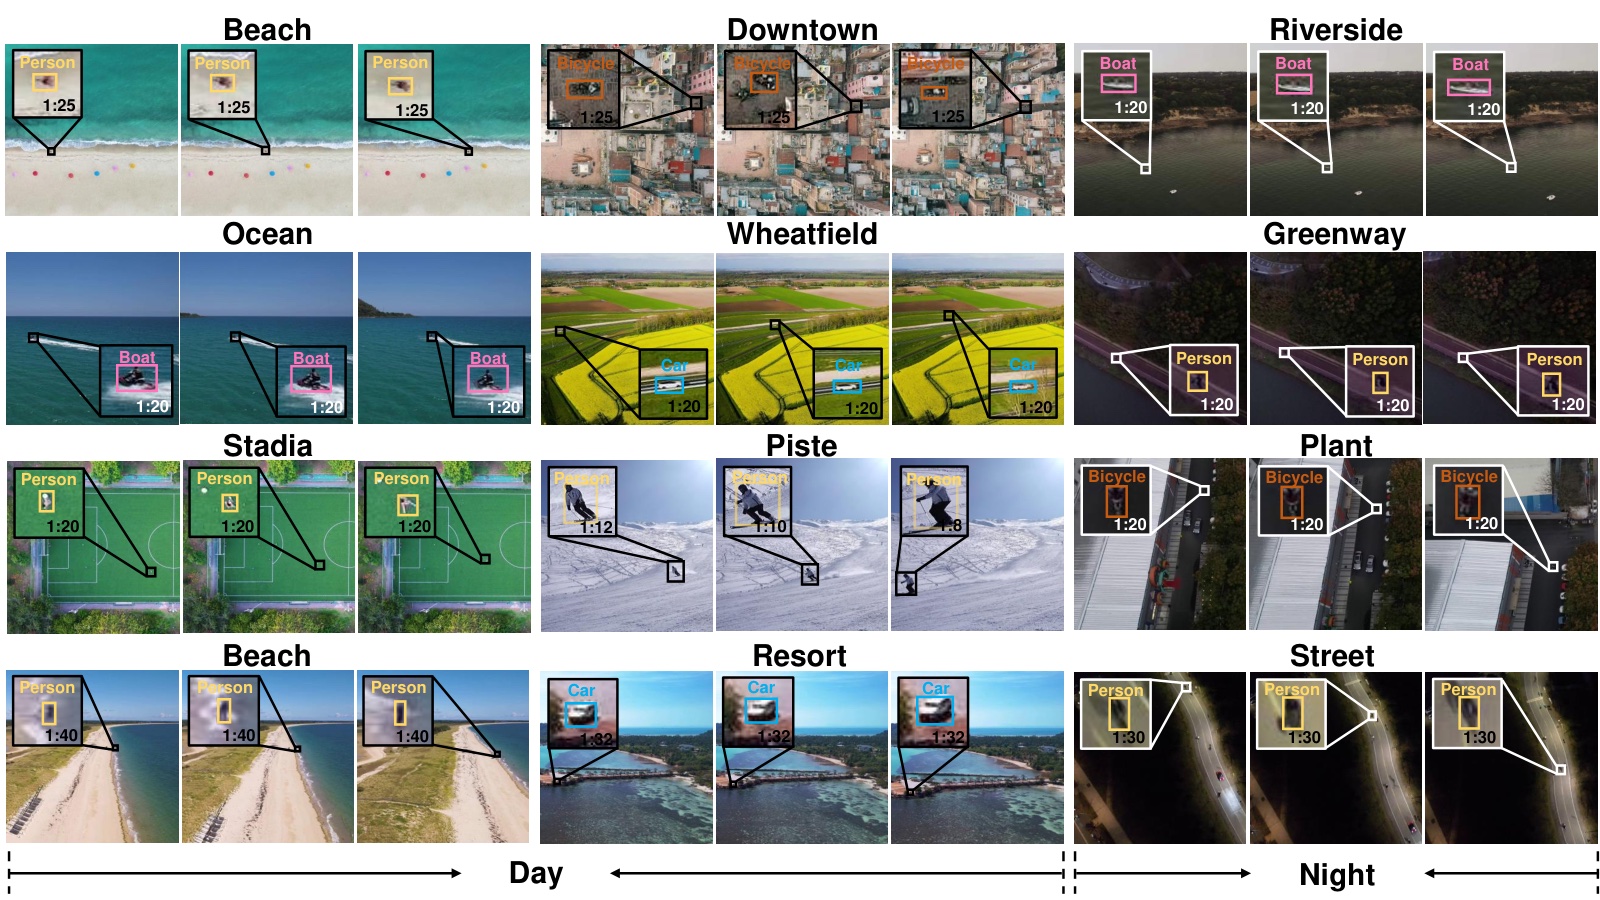
XS-VID: A Large-Scale Benchmark for Small Object Detection and Tracking in Videos
大规模视频微小目标基准,覆盖多样昼夜场景,并提出 YOLOFT 检测器——重新设计光流特征对齐,面向微小目标的检测与跟踪。
-
-
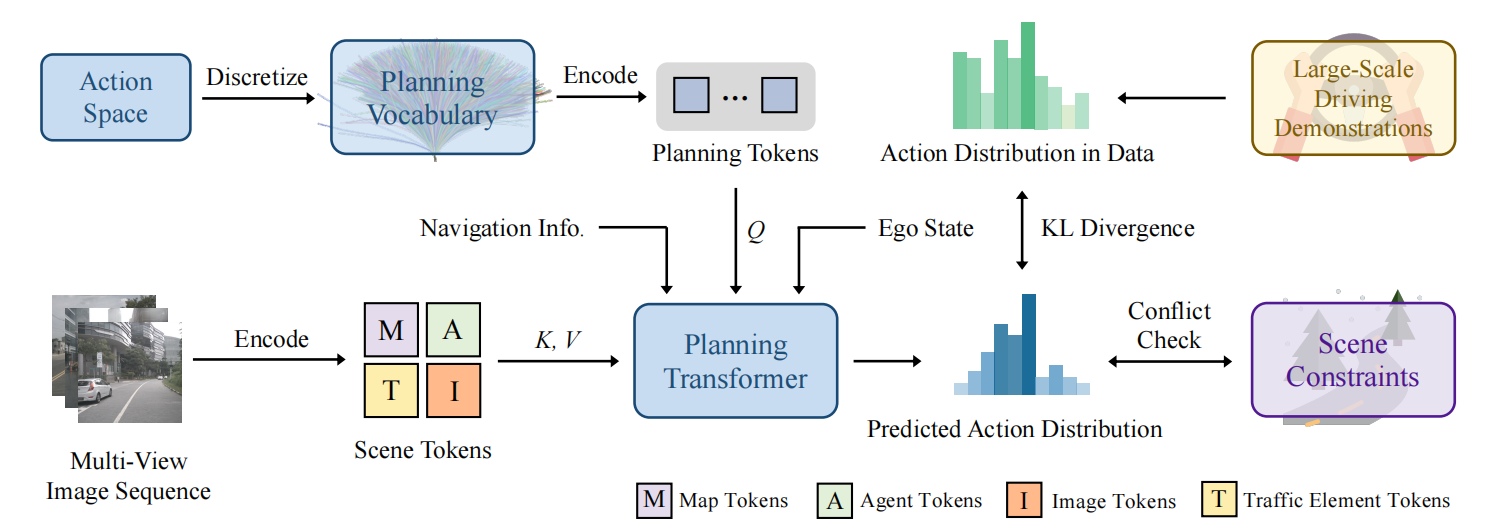
VADv2: End-to-End Autonomous Driving via Probabilistic Planning
端到端矢量化自动驾驶:从大规模驾驶示范中学习动作的概率分布,并采样一个动作控制车辆,无需规则包装即可稳定运行。
-
-
-
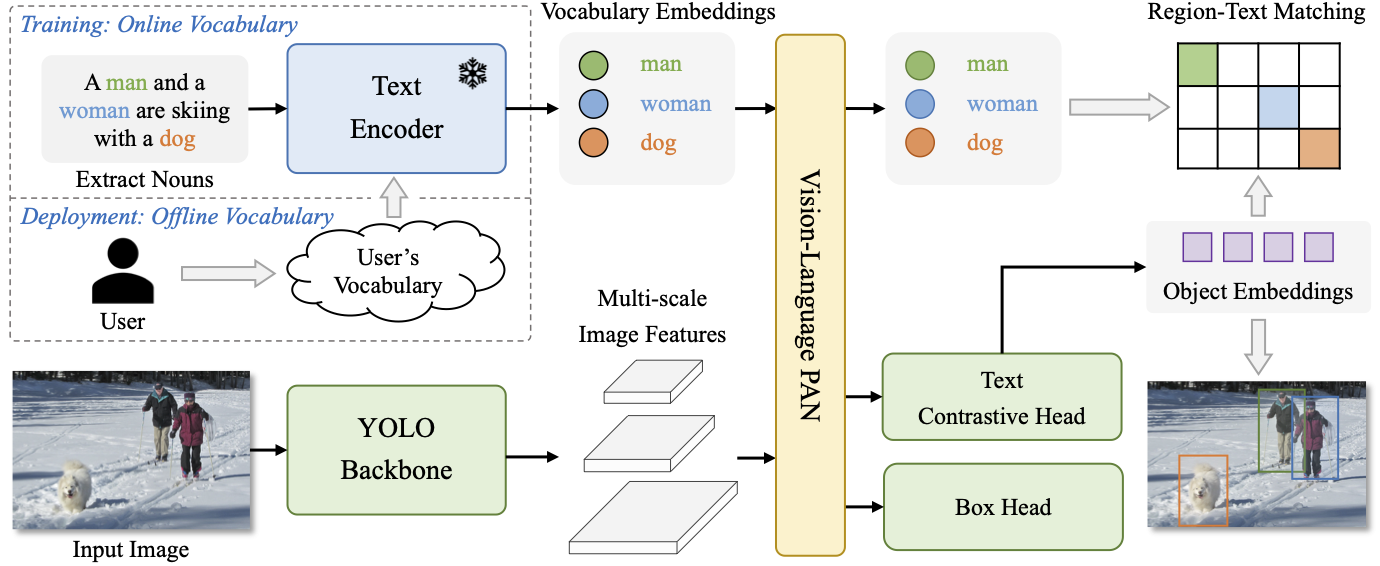
YOLO-World: Real-Time Open-Vocabulary Object Detection
实时开放词汇目标检测:通过可重参数化的 RepVL-PAN 与区域-文本对比预训练为 YOLO 注入视觉语言能力,LVIS 零样本检测达 35.4 AP / 52 FPS。
-
-
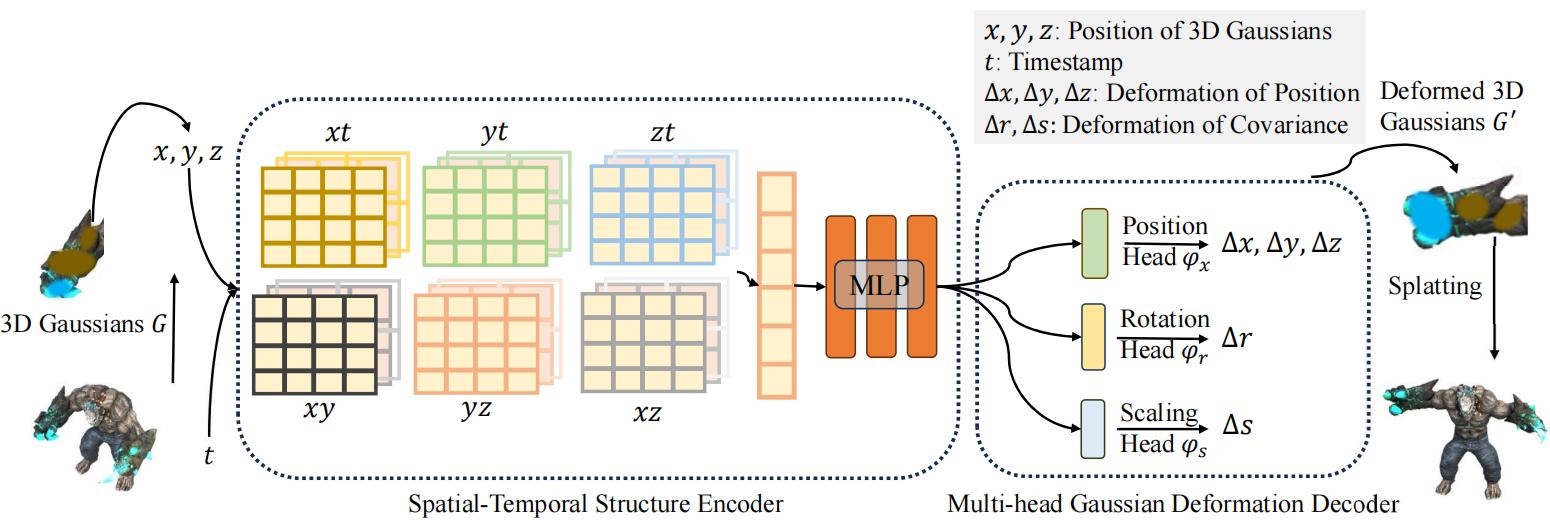
4D Gaussian Splatting for Real-Time Dynamic Scene Rendering
用高斯泼溅与紧凑的时空联合表征建模动态场景,实现高质量新视角合成的实时渲染。
-
-
-
-
-
-